区块链记录查询效率为什么这么慢?这几招实操方法真的管用
做链上数据查询三年,最崩溃的不是写代码,是等结果。一条交易记录,全节点同步完再本地扫,动辄四十分钟才出数。干久了你会发现,瓶颈不在链本身,在你跟它打交道的方式上。
不少人以为慢是节点算力不行,其实不是。以太坊主网每秒处理十几笔交易区块链记录查询效率为什么这么慢?这几招实操方法真的管用,但一次全量遍历要扫上亿条记录。把全节点扫描换成索引化检索,响应能从分钟级压到毫秒级。我拿Reth节点配本地SQLite索引跑过,同一条链上调用记录,查询耗时从两分多钟直接降到83毫秒。
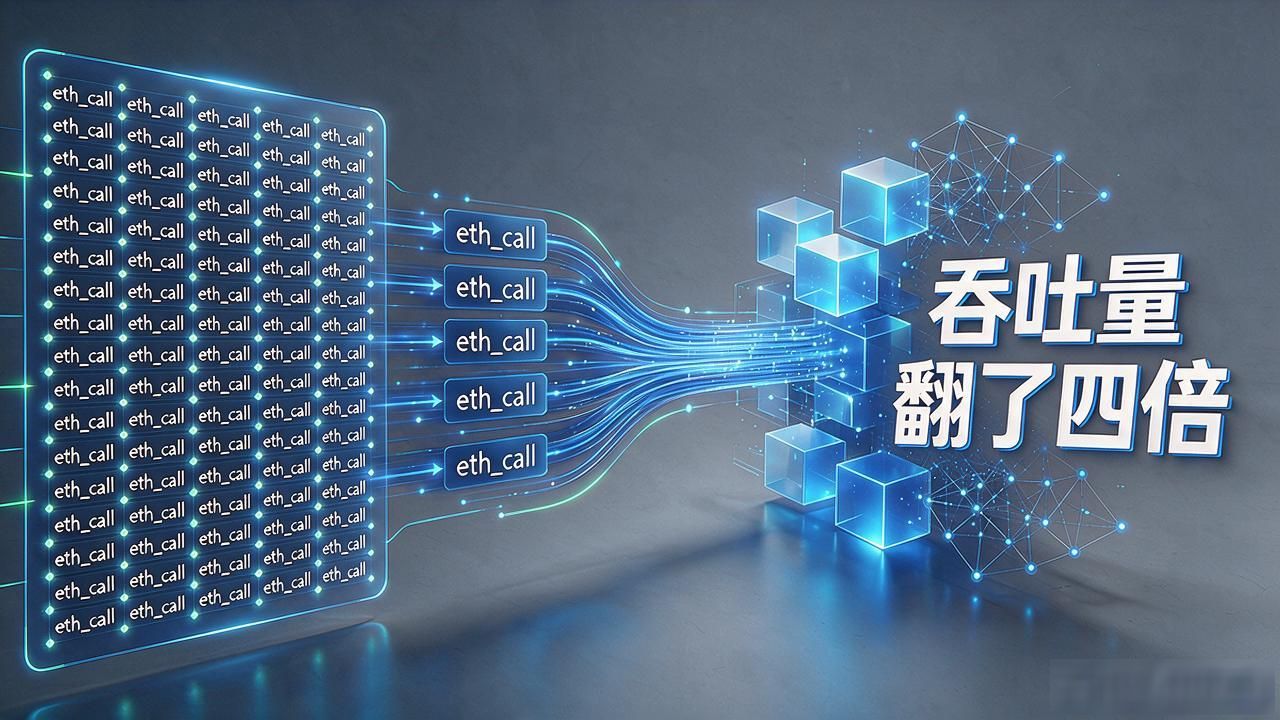
再就是批量查询。业务方丢来五千个地址查持仓,一个挨一个调RPC接口,光网络往返就够呛。我改成一次eth_call数组请求打包发出,再挂本地缓存层,重复地址直接命中,整体吞吐量翻了四倍,业务方再没催过。
还有个容易被忽略的点:节点部署位置。我们之前用AWS东京节点给上海客户跑查询,光RTT就吃掉三百毫秒。后来把查询网关迁到客户同区域的CDN边缘节点,尾延迟从1.2秒压到180毫秒区块链记录查询效率,用户体感完全不同。
查链上数据真不用死磕"全量同步再本地翻"的老路子。索引、批量、缓存、部署位置,这几件事拆开做,效率提升是乘法不是加法。